Dein Voice-Bot redet. Er denkt nicht.
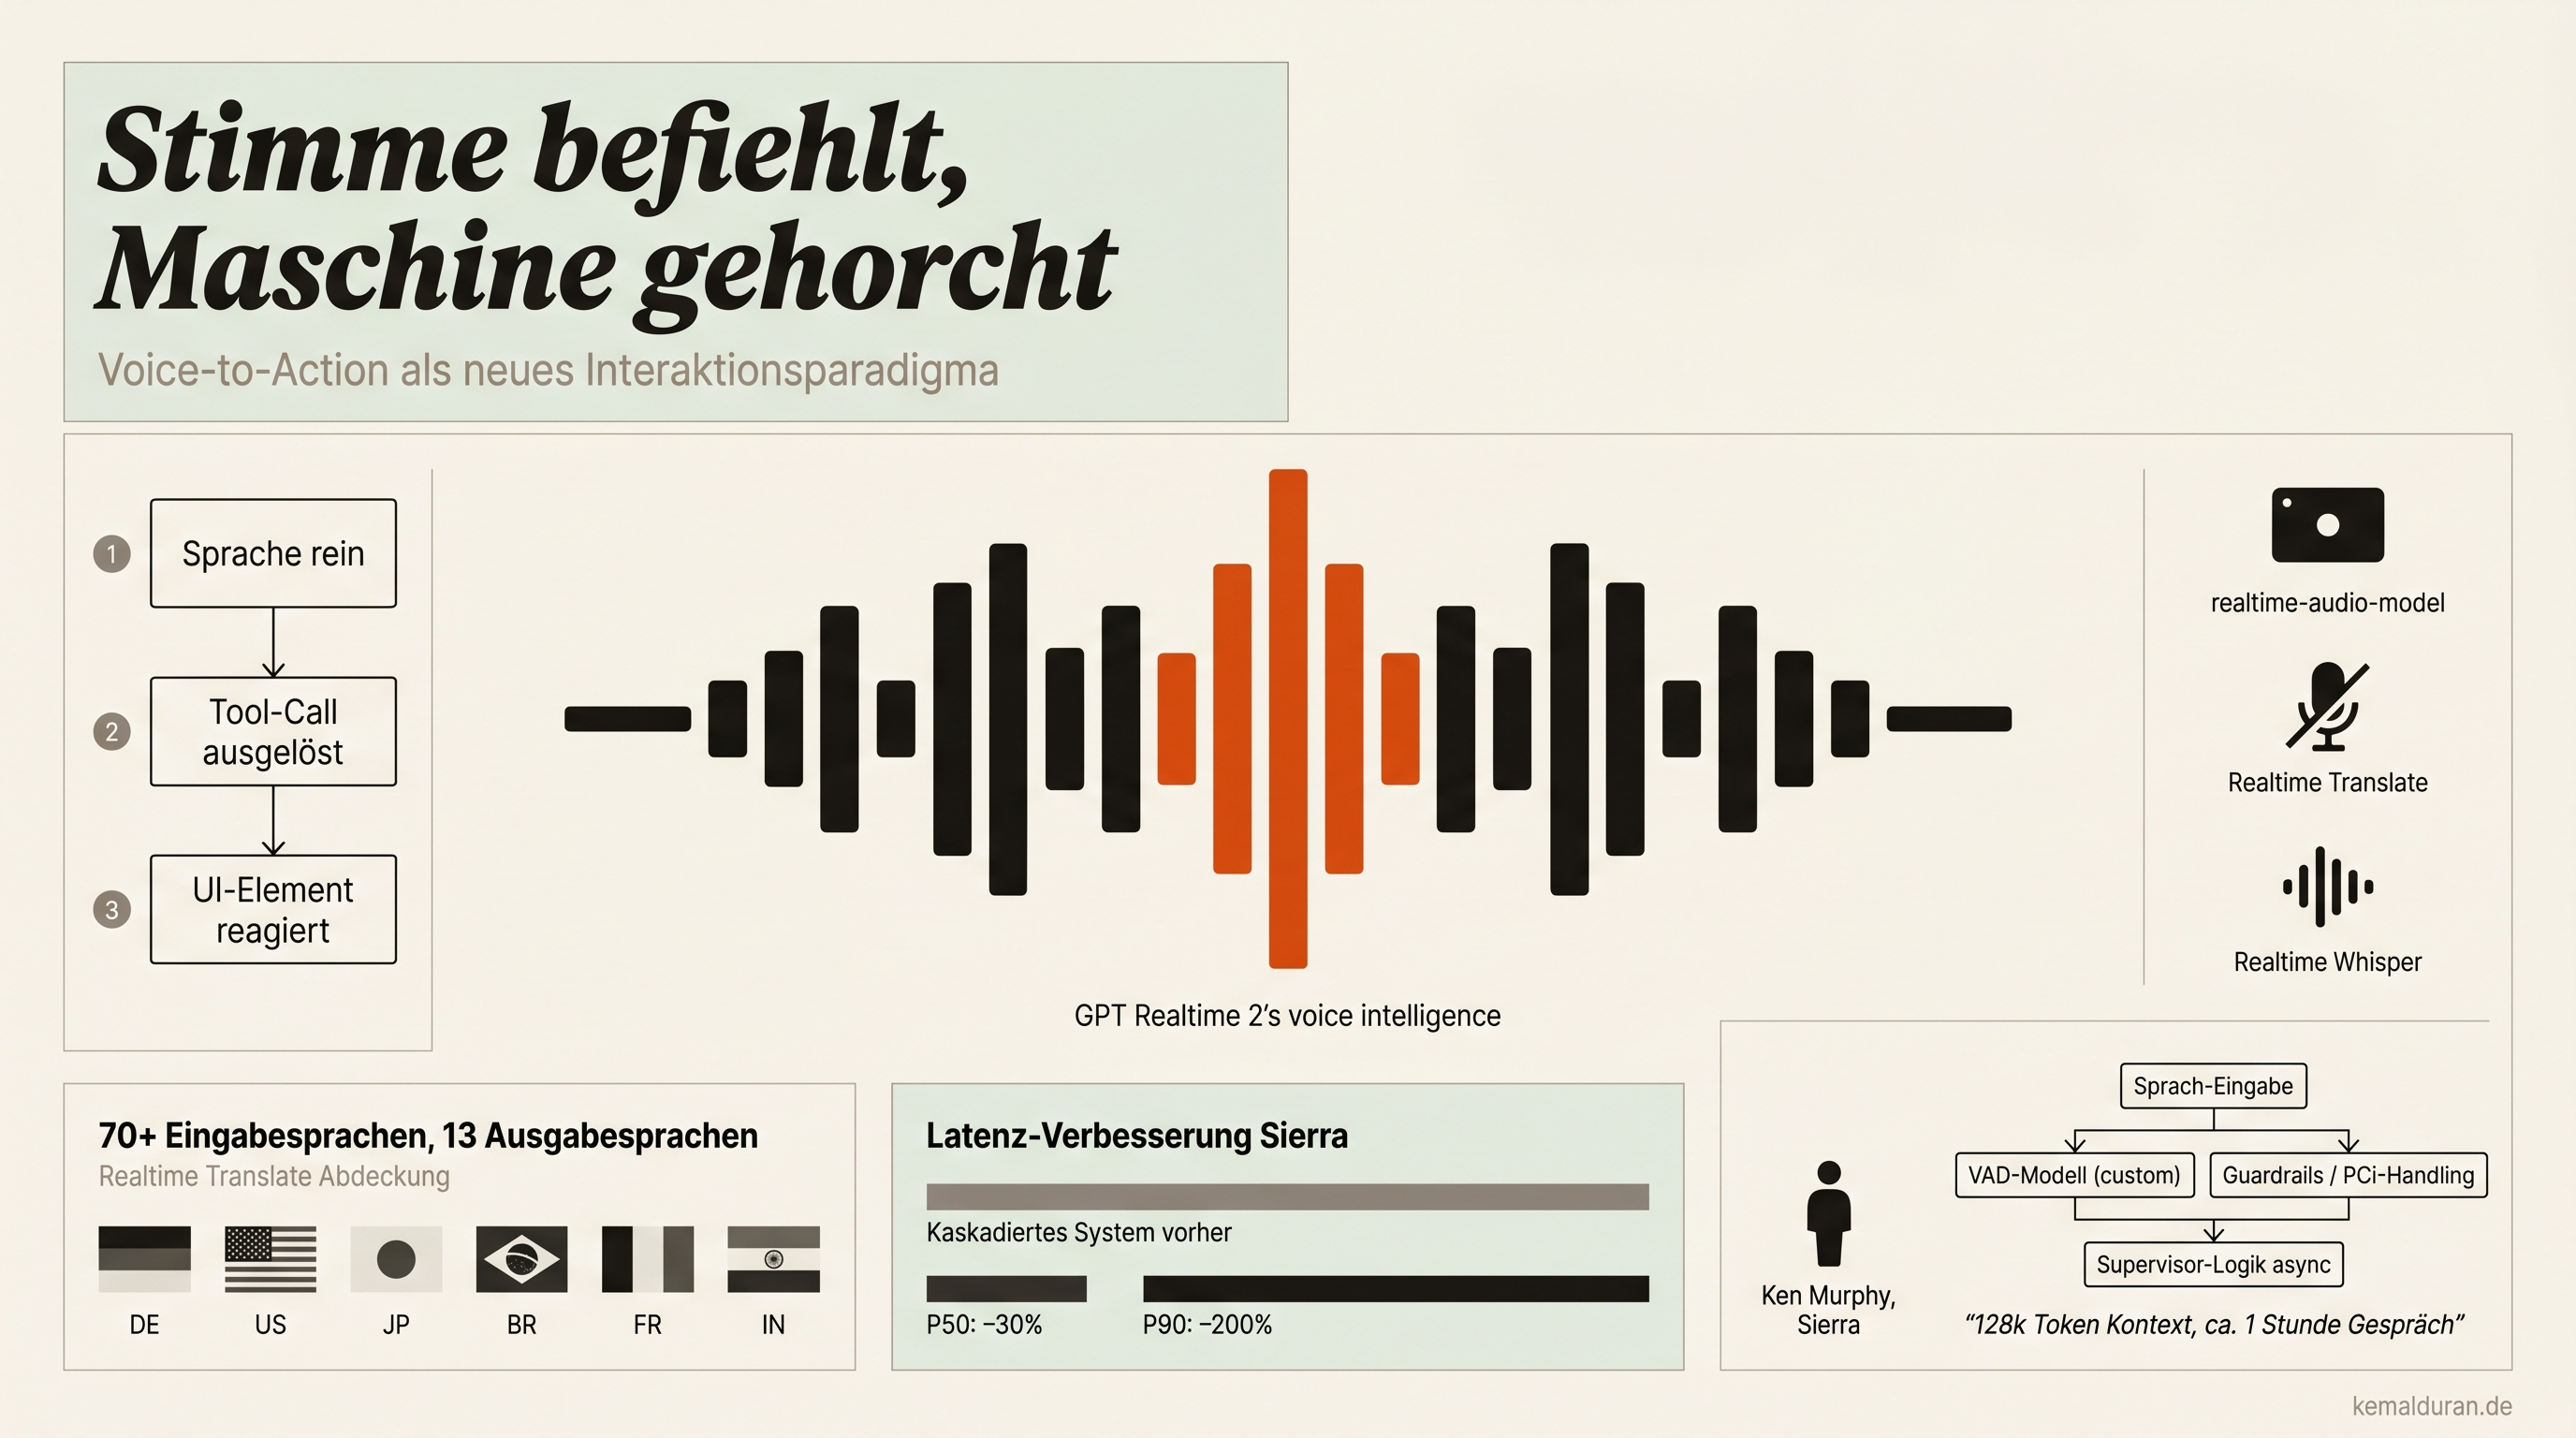
Das Problem ist nicht die Stimme. Das Problem ist das, was dahinter fehlt.
Ich sehe gerade überall dasselbe.
Startup baut Voice-Feature. Stimme klingt gut. Demo läuft durch. Erster echter User-Call, und irgendwo zwischen "Wie kann ich Ihnen helfen?" und einer Produktfrage über drei Schritte bricht das System zusammen.
Nicht weil das Modell schlecht ist.
Sondern weil das Modell allein nie das System war.
Was ich in den letzten Monaten bei Voice-Integrationen, eigenen und fremden, immer klarer sehe: Sprache als Interface ist ein eigenes Paradigma. Kein Text-Wrapper mit Mikrofon. Ein eigenes Design-Problem.
Hier ist, was ich gelernt habe.
Voice-to-Action ist kein Gimmick. Es ist die eigentliche Verschiebung.
Das klassische Pattern: User fragt. Modell antwortet. User reagiert.
Das neue Pattern: User sagt etwas. Modell denkt. Dashboard-Filter setzen. Produkt öffnet sich. Warenkorb aktualisiert. Und das Modell sagt, nichts.
Weil es nichts sagen muss.
Der Output ist die Aktion, nicht die Antwort.
Das klingt technisch. Ist es auch. Aber die strategische Implikation ist größer: Sobald ein Voice-System nicht mehr "antwortet", sondern "ausführt", ändert sich die Erwartungshaltung des Users komplett. Und damit der Wert, den du liefern kannst.
Ein Voice-Interface, das nur redet, ist schneller Dialog.
Ein Voice-Interface, das handelt, ist Automatisierung mit menschlicher Friktionsfreiheit.
Das ist kein Upgrade. Das ist eine andere Kategorie.
Das Basismodell ist der Anfang, nicht das Produkt.
Hier wird der meiste Zeit verloren.
Man nimmt ein gutes Sprachmodell, wickelt ein paar Prompts darum, lässt es reden, und nennt es Voice Agent.
Es ist kein Agent. Es ist ein Modell, das antwortet.
Was aus echten Production-Deployments bei Enterprise-Kunden mit Millionen von Calls sichtbar wird: Das Basismodell ist vielleicht dreißig Prozent der Arbeit. Der Rest ist die Harness.
Was zur Harness gehört:
Eigene VAD-Modelle. Voice Activity Detection out-of-the-box funktioniert gut in sauberem Studio-Audio. Nicht gut, wenn ein Kind im Hintergrund schreit, der Nutzer einen starken Akzent hat oder der Call aus einer lauten Fabrikhalle kommt. In echten Umgebungen brauchst du eigenes Tuning oder ein dediziertes Modell.
Workflow-Definitionen. Nicht jedes Gespräch ist gleich. Ein Kundenservice-Call für einen Telekommunikationsanbieter folgt anderen Regeln als ein medizinisches Triage-Gespräch. Diese Regeln müssen explizit modelliert sein, nicht in den Prompt gerettet werden.
Guardrails. Was darf das Modell nicht sagen? Was muss es sagen? Welche Aktionen sind in keinem Fall erlaubt, egal wie clever der User fragt? Diese Grenzen sind kein Prompt-Problem. Sie sind ein Architektur-Problem.
Session-Management. Ein Gespräch kann länger als eine Stunde gehen. Calls werden unterbrochen. User rufen zurück. Ohne explizites State-Management verlierst du den Kontext, und der User merkt es sofort.
Kontext ist die eigentliche Währung bei langen Calls.
Das spezifische Problem, das in Production am häufigsten unterschätzt wird:
Was passiert nach dreißig Minuten Gespräch? Nach einem Call-Drop?
Modelle haben Kontextfenster. Wenn ein Gespräch das Fenster überschreitet oder eine Session endet, ist der Zustand weg, es sei denn, du hast ihn gespeichert.
Die Lösung ist konzeptionell einfach: Session-State persistieren, beim nächsten Session-Start als Kontext übergeben.
Die Implementierung ist weniger einfach. Aber sie ist kein optionales Feature. Sie ist die Bedingung dafür, dass sich ein mehrstündiger oder mehrtägiger Kundendialog wie ein zusammenhängendes Gespräch anfühlt, und nicht wie ein Neustart mit Gedächtnislosigkeit.
Ein weiteres Architektur-Detail, das in Production den Unterschied macht: Asynchrone Tool-Calls. Wenn ein Hintergrundprozess läuft, Datenbankabfrage, Zahlungsvalidierung, CRM-Update, muss das Modell nicht warten und schweigen. Es kann weiterreden. Das Ergebnis wird nachträglich in die Session injiziert, ohne eine neue Modell-Antwort auszulösen.
Das ist kein Trick. Das ist die Differenz zwischen einem Call, der sich flüssig anfühlt, und einem, der sich in drei-Sekunden-Pausen ruckelt.
Kritische Passagen brauchen Kontrolle, keine Höflichkeit.
Ein Use-Case, den die meisten übersehen, bis er zu einem Compliance-Problem wird:
Rechtliche Disclaimers. Pflichtinformationen. Datenschutzhinweise.
In einem normalen Gespräch unterbricht der User. Das ist gut. Das ist menschlich.
Bei einer Pflichtaussage ist es ein Problem.
Die Lösung: VAD für diese spezifischen Turns deaktivieren. Das Modell spricht durch. Garantiert. Keine Unterbrechungsmöglichkeit, bis die Aussage abgeschlossen ist.
Das klingt nach einem kleinen technischen Detail.
Für Fintech, Healthcare, Insurance ist es der Unterschied zwischen einem compliant-fähigen System und einem, das im ersten Audit fällt.
Thinking-Modelle sind ein echter Wendepunkt. Aber mit einem Haken.
Die besten Voice-Agenten in Production, die ich bisher analysiert habe, bewegen sich weg von reinen Reaktionsmodellen hin zu Modellen, die tatsächlich nachdenken, bevor sie antworten.
Das ist gut für Qualität.
Das ist schlecht für Latenz.
Der Haken: Ein Voice-Agent, der denkt, muss trotzdem gesprächsfähig bleiben. Er muss Unterbrechungen korrekt handhaben. Er muss erkennbar machen, dass er noch da ist, auch während er rechnet.
Das ist kein Modell-Problem. Das ist ein Interaktions-Design-Problem.
Wie verhält sich das System in der Denkpause? Was hört der User? Stille? Ein Signal? Eine kurze Bestätigung?
Diese Mikro-Entscheidungen bestimmen, ob sich ein Voice-Agent intelligent anfühlt oder wie ein System, das hängt.
Prompt-Hygiene vor dem Go-Live. Nicht danach.
Ein einfacher, oft übersprungener Schritt:
Bevor ein Prompt in Production geht, lass das Modell selbst prüfen, ob er widersprüchliche Instruktionen enthält.
Widersprüche im Prompt sind der häufigste Grund für inkonsistentes Verhalten, das sich in Logs nicht sofort erklären lässt. Das Modell folgt, aber welcher Instruktion, ist nicht determiniert.
Selbst-Audit kostet fünf Minuten. Das Debugging danach kostet Tage.
Was das für dich bedeutet, wenn du Voice in ein Produkt baust.
Voice ist nicht die Oberfläche. Voice ist das Interface zu einer Architektur, die darunter liegen muss.
Wenn die Architektur fehlt, ist die Stimme nur Kulisse.
Wenn die Architektur stimmt, ist Voice das natürlichste Interface, das ein Nutzer je hatte, weil er gar nicht merkt, dass er mit einem System spricht.
Das ist der Unterschied.
Und der entscheidet, ob dein Voice-Feature eine Demo bleibt oder ein Produkt wird.
FAQ
Was ist eine Voice-Agent-Harness?
Die Harness ist die Summe aller Systeme, die um das reine Sprachmodell herum gebaut werden, damit ein Voice-Agent zuverlässig funktioniert. Dazu gehören VAD-Modelle, Workflow-Definitionen, Guardrails und Session-Management. Ohne Harness bleibt das Modell nur eine Komponente, die auf Fragen antwortet, statt ein Gespräch verlässlich zu führen.
Was bedeutet VAD bei Voice AI?
VAD steht für Voice Activity Detection, also die Erkennung, wann ein Nutzer spricht und wann nicht. In sauberer Studioumgebung funktioniert Standard-VAD gut, in lauten oder akzentreichen Umgebungen oft nicht zuverlässig. Deshalb brauchen produktive Voice-Systeme meist eigenes Tuning oder ein dediziertes VAD-Modell.
Warum verliert mein Voice-Bot den Kontext bei langen Gesprächen?
Sprachmodelle arbeiten mit einem begrenzten Kontextfenster. Wenn ein Gespräch dieses Fenster überschreitet oder eine Session durch einen Call-Drop unterbrochen wird, geht der bisherige Gesprächsstand verloren. Die Lösung ist, den Session-State zu speichern und ihn beim nächsten Sessionstart wieder als Kontext einzuspielen.
Was sind asynchrone Tool-Calls bei Voice AI?
Asynchrone Tool-Calls erlauben es dem Modell, während ein Hintergrundprozess wie eine Datenbankabfrage oder Zahlungsvalidierung läuft, weiterzureden statt zu schweigen. Das Ergebnis des Prozesses wird nachträglich in die Session eingespielt, ohne dass dafür eine neue Antwort des Modells nötig ist. Das verhindert unnatürliche Pausen im Gesprächsfluss.
Warum sind Thinking-Modelle für Voice-Agenten ein Problem?
Thinking-Modelle denken vor der Antwort nach, was die Qualität der Antworten verbessert, aber die Latenz erhöht. Bei Voice-Interfaces führt das dazu, dass der Agent während der Denkpause gesprächsfähig bleiben und Unterbrechungen weiter korrekt verarbeiten muss. Das ist kein reines Modellproblem, sondern eine Frage des Interaktionsdesigns während der Wartezeit.