Warum dein KI-Agent nicht aufhört, bis er fertig ist
Der Moment, in dem du aufgehört hast, aufzupassen
Du gibst einem KI-Agenten einen Task.
Er arbeitet.
Du machst einen Kaffee, antwortest auf eine Nachricht, schaust kurz aus dem Fenster.
Und wenn du zurückkommst: fertig.
Nicht "irgendwie angefangen". Fertig.
Das ist kein Zufall. Das ist Architektur.
Und wer die versteht, setzt KI-Tools ab sofort anders ein.
Was tatsächlich passiert, wenn Claude Code arbeitet
Die meisten denken, ein KI-Agent läuft einmal durch und liefert ein Ergebnis.
So funktioniert das nicht.
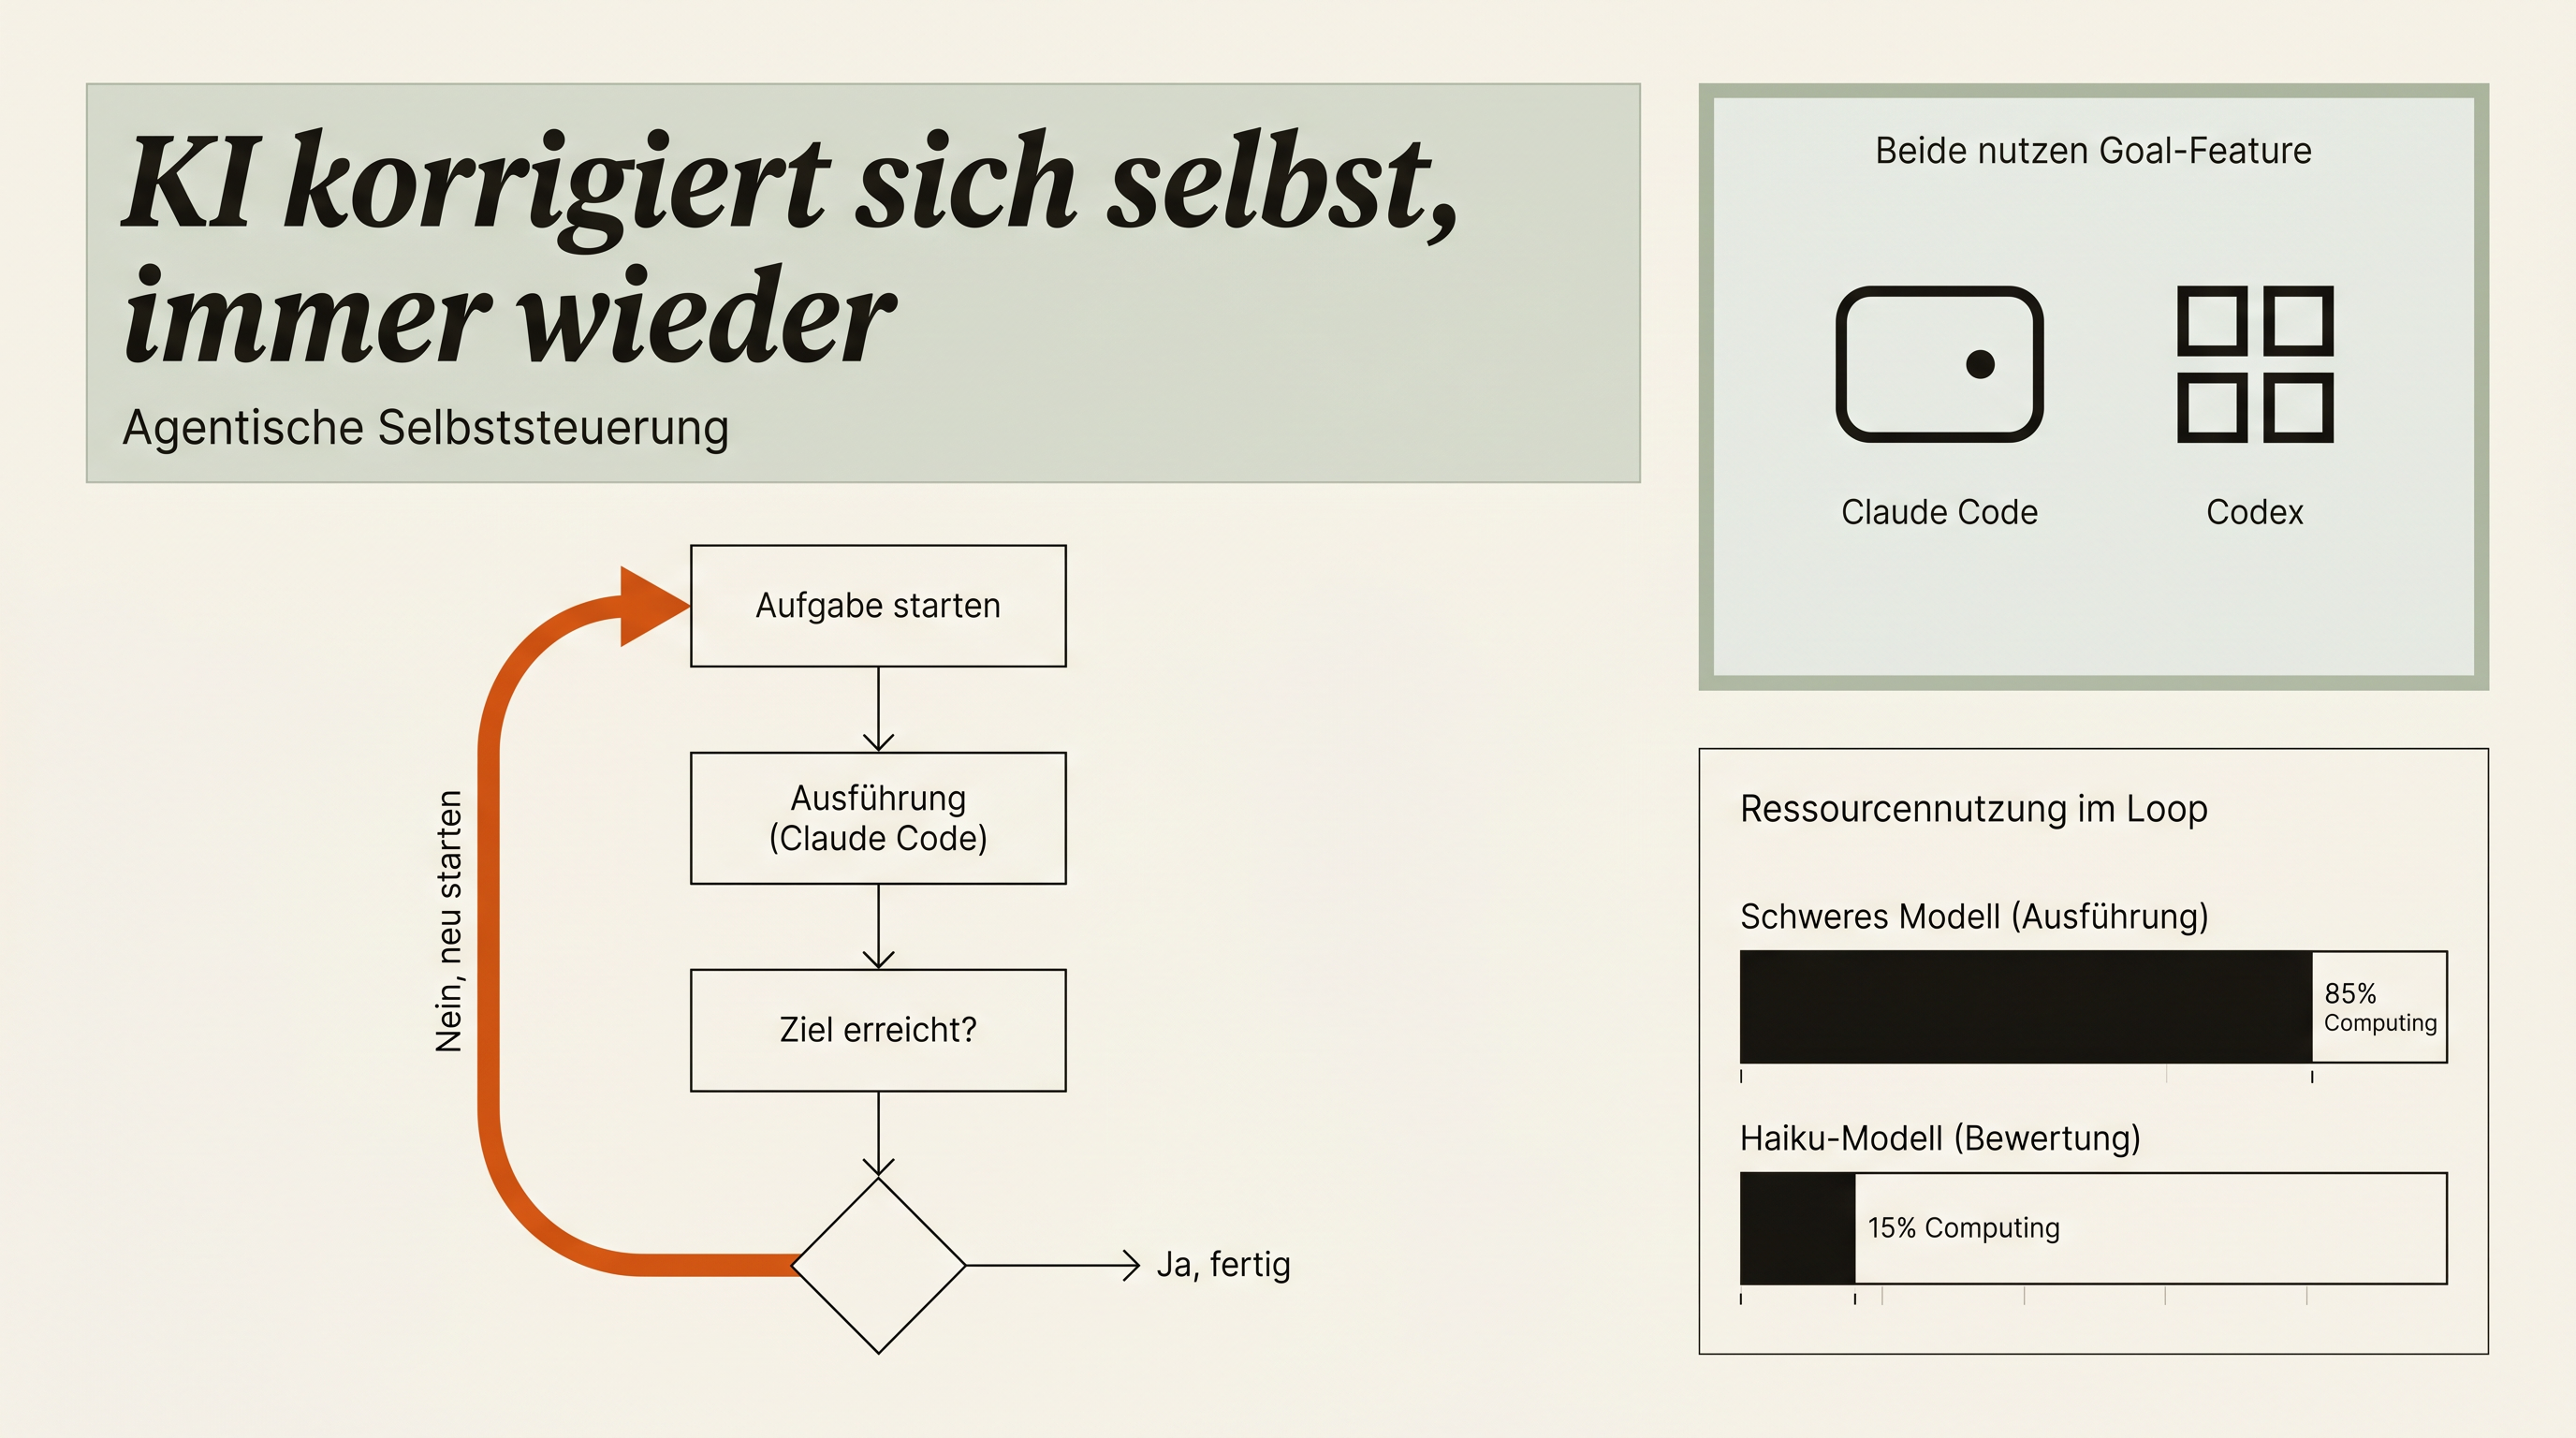
Claude Code arbeitet in Loops.
Nach jedem Durchlauf stellt das System eine interne Frage: Ist das Ziel erreicht?
Wenn nein: nochmal.
Der Bewerter ist dabei nicht dasselbe Modell, das den Code schreibt. Claude Haiku, ein deutlich leichtgewichtigeres Modell, übernimmt die Rolle des Evaluators. Es liest den Output, vergleicht ihn mit der definierten Fertigstellungsbedingung und entscheidet: weiter oder stopp.
Schweres Modell für Ausführung. Leichtes Modell für Bewertung.
Das ist eine kluge Architekturentscheidung, keine Einsparlösung.
Das eigentliche Werkzeug: Definition of Done
Das Goal-Feature in Claude Code existiert schon eine Weile. Die meisten nutzen es nicht.
Stattdessen tippen sie einen Task in ein Prompt-Feld, warten, schauen das Ergebnis an und korrigieren manuell.
Der Unterschied zwischen diesem Ablauf und einem echten agentischen Workflow ist eine einzige Frage:
Wann gilt der Task als abgeschlossen?
Nicht "was soll passieren", sondern "woran erkennst du, dass es geklappt hat".
Das ist eine andere Art zu denken.
Wer ein Erfolgskriterium definiert, gibt dem System einen Anker. Der Agent läuft nicht ins Leere, er läuft auf ein Ziel zu. Und wenn er das Ziel nicht trifft, startet er neu, ohne dass du eingreifen musst.
Niemand braucht dich für den nächsten Prompt.
Warum das praktisch relevant ist, nicht nur theoretisch
Ich baue gerade mehrere Systeme gleichzeitig. Mamko auf der einen Seite, CUVIR-Projekte auf der anderen. Dazu kleinere Tools, die ich für Beratungsmandate aufsetze.
Die Ressource, die dabei am knappsten ist, ist nicht Kapital. Nicht Zeit im klassischen Sinne.
Es ist Aufmerksamkeit.
Jeder manuelle Loop, den ich selbst durchführe, kostet Aufmerksamkeit, die ich nicht mehr für Entscheidungen habe, die tatsächlich meine Einschätzung brauchen.
Der Selbstkorrektur-Loop von Claude Code gibt mir diese Aufmerksamkeit zurück.
Ich beschreibe einmal, wann ein Task erledigt ist. Das System arbeitet, bis diese Bedingung erfüllt ist. Ich sehe das Ergebnis.
Fertig.
Ein Muster, das du in eigene Systeme übersetzen kannst
Wenn du eigene Agenten baust oder Workflows zusammensetzt, lohnt sich dieses Prinzip als Architekturgedanke:
Trenne Ausführung und Bewertung.
Das ausführende Modell ist nicht der beste Bewerter seiner eigenen Arbeit. Nicht weil es schlecht ist, sondern weil Bewertung eine andere Aufgabe ist als Ausführung. Ein dediziertes Evaluator-Modell, auch wenn es kleiner ist, urteilt sauberer, weil es keine Eigeninteressen an seinem Output hat.
Die Frage "Habe ich das Ziel erreicht?" ist strukturell anders als "Was ist der nächste Schritt?"
Wer das trennt, baut stabilere Systeme.
Das konkrete Vorgehen, wenn du es heute testen willst
Nimm einen Task, den du Claude Code normalerweise einmal laufen lässt.
Formuliere nicht nur den Task.
Formuliere das Erfolgskriterium.
Nicht: "Schreib eine Funktion, die X macht."
Sondern: "Die Aufgabe ist abgeschlossen, wenn die Funktion X macht, alle Edge-Cases aus dem ursprünglichen Prompt abdeckt und die Tests ohne Fehler durchlaufen."
Das ist der Unterschied.
Starte den Loop. Lass ihn laufen. Schau, wie viele Iterationen das System braucht, um deine Definition of Done zu erfüllen.
Dann entscheide, ob du die Kriterien schärfer oder weicher formulieren willst.
Du wirst nach dem ersten Durchlauf ein Gefühl dafür entwickeln, wie präzise du sein musst.
Was das über den Stand der Dinge aussagt
Beide großen Coding-Agenten, Claude Code und Codex, haben das Goal-Feature eingeführt.
Das ist kein Zufall.
Der Trend geht weg von "einmal ausführen, Nutzer korrigiert" hin zu "iterativer Eigenkorrektur bis zur definierten Qualität".
Wer das nur als technisches Detail sieht, verpasst den Punkt.
Der Punkt ist: KI-Agenten werden zunehmend eigenständig in dem Sinne, dass sie nicht mehr darauf angewiesen sind, dass du nach jedem Schritt schaust, ob alles stimmt.
Das ändert, wie du Aufgaben delegierst.
Nicht mehr: "Mach das." Mit Ergebnis-Check alle fünf Minuten.
Sondern: "Mach das. Hier ist, wann du fertig bist. Ich schaue wieder rein, wenn du es mir sagst."
Das ist eine andere Beziehung zum Werkzeug.
Und wer diese Beziehung jetzt etabliert, hat in zwölf Monaten einen erheblichen Vorsprung gegenüber denen, die immer noch jeden Prompt manuell nachfassen.
FAQ
Was ist ein Selbstkorrektur-Loop bei KI-Agenten?
Ein Selbstkorrektur-Loop ist ein Ablauf, bei dem ein KI-Agent seinen eigenen Output nach jedem Durchlauf gegen ein definiertes Ziel prüft. Erfüllt das Ergebnis das Ziel nicht, startet der Agent automatisch einen neuen Durchlauf, ohne dass jemand eingreifen muss. Das läuft so lange weiter, bis die vorher festgelegte Fertigstellungsbedingung erreicht ist.
Warum nutzt Claude Code ein anderes Modell zur Bewertung als zur Ausführung?
Weil Bewertung eine andere Aufgabe ist als Ausführung. Claude Haiku übernimmt bei Claude Code die Rolle des Evaluators und prüft den Output des schwereren Ausführungsmodells gegen die Fertigstellungsbedingung. So urteilt ein Modell ohne Eigeninteresse am eigenen Output über den Fortschritt, was zu saubereren Entscheidungen führt.
Was bedeutet Definition of Done bei KI-Agenten konkret?
Definition of Done ist die klare Beschreibung, woran ein Agent erkennt, dass eine Aufgabe abgeschlossen ist. Statt nur zu beschreiben, was passieren soll, legst du fest, welche Bedingungen erfüllt sein müssen, zum Beispiel dass alle Edge-Cases abgedeckt sind und Tests fehlerfrei durchlaufen. Diese Definition ist der Anker, an dem sich der Selbstkorrektur-Loop orientiert.
Welche Coding-Agenten unterstützen aktuell einen solchen Goal-basierten Loop?
Sowohl Claude Code als auch Codex haben laut Artikel ein Goal-Feature eingeführt, das iterative Eigenkorrektur bis zur definierten Qualität ermöglicht. Damit setzen beide großen Coding-Agenten auf denselben Trend weg von einmaligem Ausführen mit manueller Nutzerkorrektur. Die konkrete technische Umsetzung, etwa welches Modell intern bewertet, unterscheidet sich dabei je nach Anbieter.
Muss ich für jeden Task ein Erfolgskriterium formulieren, damit der Loop funktioniert?
Ja, ohne definiertes Erfolgskriterium hat der Agent keinen Anker und weiß nicht, wann er aufhören soll. Die Formulierung sollte konkret sein, also nicht nur beschreiben was die Lösung tun soll, sondern woran die Fertigstellung erkennbar ist. Je präziser das Kriterium, desto zielgerichteter läuft der Loop, das Gefühl für die richtige Präzision entwickelt sich meist erst nach dem ersten Durchlauf.